
Mới nhất, hôm 8.10, USA Today Co. cùng một số cơ quan báo chí nộp đơn kiện OpenAI lên tòa án liên bang ở Manhattan (Mỹ). Theo Reuters, nguyên đơn cáo buộc OpenAI tự ý sao chép hàng trăm nghìn bài báo để huấn luyện các mô hình AI đứng sau ChatGPT, đồng thời yêu cầu mức bồi thường hơn 250 triệu USD (khoảng 6.300 tỉ đồng). Phía OpenAI chưa đưa ra phản hồi chính thức. Đây hiện vẫn là cáo buộc từ phía nguyên đơn và chờ phán quyết từ tòa án.
Vụ kiện một lần nữa xoáy vào mâu thuẫn lớn nhất thời đại AI: Các hệ thống thông minh này lấy dữ liệu từ đâu, và người sáng tạo được gì khi tác phẩm của mình trở thành "nguyên liệu" cho công nghệ?
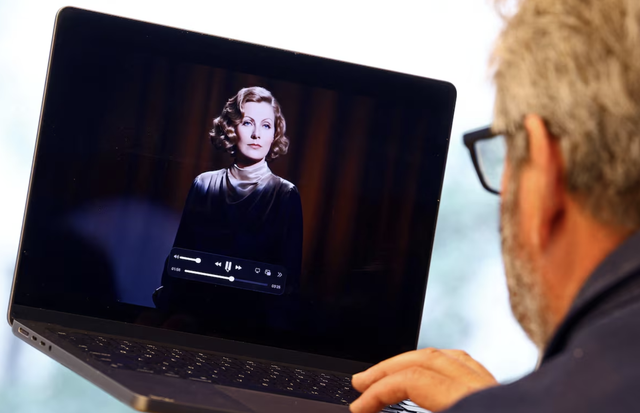
Hình ảnh Greta Garbo được tái tạo bằng AI cho một chiến dịch quảng cáo, đặt ra câu hỏi về quyền sử dụng hình ảnh và di sản của nghệ sĩ
Ảnh: REUTERS
Cuộc chiến bản quyền AI từ trang báo đến âm nhạc
Đằng sau một mô hình AI biết sáng tạo là quá trình "ngốn" lượng dữ liệu khổng lồ gồm văn bản, hình ảnh và âm thanh... Thế nhưng, một tác phẩm nằm công khai trên mạng không có nghĩa là nó nghiễm nhiên mất đi quyền bảo hộ.
Theo Reuters, các hãng công nghệ Mỹ từng viện dẫn lý do "sử dụng hợp lý" (fair use) để bào chữa cho việc dùng dữ liệu có bản quyền huấn luyện AI. Dù vậy, đây vẫn là khoảng trống pháp lý đang tranh cãi gắt gao tại tòa án chứ chưa có kết luận chung cho mọi trường hợp.
Tranh chấp giữa hãng Anthropic và các tác giả sách cho thấy thêm một góc khuất khác: nguồn gốc của dữ liệu. AP đưa tin hồi tháng 7.2026, một thẩm phán liên bang Mỹ đã phê chuẩn thỏa thuận dàn xếp trị giá 1,5 tỉ USD (khoảng 37.800 tỉ đồng). Theo đó, Anthropic chấp nhận bồi thường khoảng 3.000 USD (hơn 75 triệu đồng) cho mỗi cuốn sách đủ điều kiện, liên quan đến việc dùng các bản sao lậu để huấn luyện chatbot Claude. Thỏa thuận này cho thấy tranh chấp dữ liệu đầu vào hoàn toàn có thể dẫn đến những cơ chế bồi thường rất cụ thể.
Trong mảng âm nhạc, câu chuyện còn phức tạp hơn khi AI có thể nhái giọng hay phong cách của nghệ sĩ. Theo Reuters, hồi tháng 9.2026, một nhóm nhạc sĩ đã đệ đơn kiện Công ty tạo nhạc Suno tại Mỹ vì tự ý dùng tên tuổi, hình ảnh và đặc điểm nhận diện của họ để người dùng tạo ra các bài hát mô phỏng. Suno bác bỏ cáo buộc, khẳng định công cụ của họ hướng đến việc tạo ra âm nhạc mới.
Các bộ sách số hóa mang đến nguồn dữ liệu phong phú cho AI, nhưng cũng dấy lên tranh cãi về bản quyền
Ảnh: AP
Bài toán minh bạch và lối đi cho người sáng tạo
Trong khi Mỹ xử lý tranh chấp qua từng vụ kiện riêng lẻ, Liên minh châu Âu (EU) chọn cách "siết" bằng pháp luật. Điều 53 trong đạo luật AI (AI Act) của EU buộc các nhà cung cấp AI phải tuân thủ luật bản quyền và công khai bản tóm tắt chi tiết về dữ liệu dùng để huấn luyện. Theo Ủy ban châu Âu, quy định này giúp tác giả biết tác phẩm của mình có bị dùng hay không để từ đó bảo vệ quyền lợi.
Nhật Bản lại chọn hướng linh hoạt hơn. Trong hướng dẫn công bố vào tháng 5.2024, Cơ quan Văn hóa Nhật Bản giải thích rõ hơn về quy định sử dụng tác phẩm cho mục đích phân tích thông tin, dù đây chỉ là văn bản hướng dẫn chứ chưa phải luật ràng buộc tuyệt đối.
Thực tế, với một tập đoàn hay nhà xuất bản lớn, việc phát hiện nội dung bị dùng chui và theo đuổi vụ kiện còn khả thi. Mọi thứ khó khăn hơn nhiều với những họa sĩ, nhà văn hay nhạc sĩ độc lập. Nếu không có tính minh bạch, họ gần như không thể biết tác phẩm của mình đã bị đưa vào kho dữ liệu AI từ lúc nào để đòi quyền lợi hay đàm phán cấp phép.
Tranh chấp bản quyền AI không đơn thuần là cuộc đấu giữa các tập đoàn công nghệ và các đơn vị nắm giữ bản quyền. Đó là câu chuyện về sinh kế và tương lai của những người làm nghệ thuật lẫn báo chí. Không thể quy chụp mọi hoạt động huấn luyện AI đều là vi phạm, nhưng cũng không thể coi việc nội dung xuất hiện trên internet là sự đồng ý cho AI xài "chùa". Chỉ khi có một cơ chế rõ ràng, công nghệ mới tiến xa mà người làm sáng tạo không bị thiệt thòi.